
オンライン会議をローカルで文字起こししたい。会議にボットを参加させず、音声を外部の文字起こしサービスへ送らずに議事録を作りたい。その用途に向けて、Local Transcriber 0.7.0では、PCで再生される相手の声と自分のマイクを一緒に録音できるようになりました。
対応するWindows・Macで録音を止めると、PC内のAIモデルが文字起こしします。用語集で社名や製品名の表記を伝え、必要なら試験的な話者分離で発言者の番号も付けられます。会議中に文字をリアルタイム表示する方式ではありません。
この記事では、オンライン会議の録音から文字の確認・保存までを説明します。更新点だけを確認したい場合は、Local Transcriber 0.7.0の公開案内をご覧ください。ダウンロードは製品ページから進められます。
記述は0.7.0のコードと公式資料に基づきます。掲載する画面はソースから起動したブラウザの画面です。Windows・Macの配布アプリを使った実会議での録音と精度の比較は、今回の記事制作では行っていません。
なぜオンライン会議の文字起こしをローカルで行うのか
音声を追加で預けるサービスを減らせる
議事録を作る担当者にとって、録音を残せることと、その音声を文字起こしサービスへアップロードできることは別の条件です。会議は許可されたオンライン会議サービスで行えても、録音の二次利用や外部サービスへの持ち出しには制限がある場合があります。
Local Transcriberは、文字起こし用のモデルを自分のPCに置き、そのPCで計算します。アプリが会議音声を外部の文字起こしAPIへ送る処理はありません。APIキーや文字起こしサービスのアカウントを用意せずに使えます。
ただし、オンライン会議そのものの通信までなくなるわけではありません。Zoom・Teams・Google Meetで会話する通信と、録音した音声を文字に変える処理を分けて考えてください。ローカルになるのはLocal Transcriberが担当する録音の保存と文字起こしです。
社外への送信を禁止するルールがあっても、録音自体や未承認アプリの利用まで許可されるとは限りません。録音の同意を得たうえで、使うPC、保存するフォルダ、共有する範囲を会社や取引先との取り決めに合わせます。
クラウド型とは、処理を行う場所が違う
クラウドで文字起こしするサービスを検討したものの、音声を外部サービスに預ける条件が合わない人にとって、ローカル処理は別の選択肢になります。クラウド型サービスの安全性を一括りに評価する話ではありません。各社の契約や保存方針、会社側の利用条件に合わせて選ぶ必要があります。
| 比べる点 | クラウドで文字起こしする方式 | Local Transcriber 0.7.0 |
|---|---|---|
| 文字起こしの計算 | サービス側の環境で処理 | 利用者のPCで処理 |
| 音声の扱い | 送信先や保存条件をサービスごとに確認 | アプリの音声処理は端末内で完結 |
| PC側の準備 | サービスの利用条件に従う | 初回に文字起こしモデルを取得 |
| 結果の管理 | 各サービスの保存・共有機能に従う | 書き出したファイルを自分で管理 |
| 処理に使う資源 | サービス側の計算環境に依存 | 自分のPCのメモリやCPU・GPUを使用 |
ローカル処理を選ぶと、音声を預ける先は減らせます。一方で、PCの空き容量、文字起こしに使う時間、出力ファイルの保管は利用者側で考える必要があります。端末内に残った音声や文章を、誰が開けるかまで含めて運用を決めるのが適切です。
0.7.0でできるようになったこと
相手の声と自分の声を、一つの録音にする
これまでのマイク録音では、ヘッドホンから聞いている相手の声はマイクに入りません。0.7.0はPCの再生音声を取り込み、選んだマイクの音声と合成して録音します。会議サービスに録音ボットを参加させる手順はありません。
録音パネルのPC で再生中の音声も録る(オンライン会議用)をONにすると利用できます。デフォルトはOFFです。以前にONにして使ったデスクトップアプリでは設定が保存されるため、会議のたびに現在の状態を確認してください。
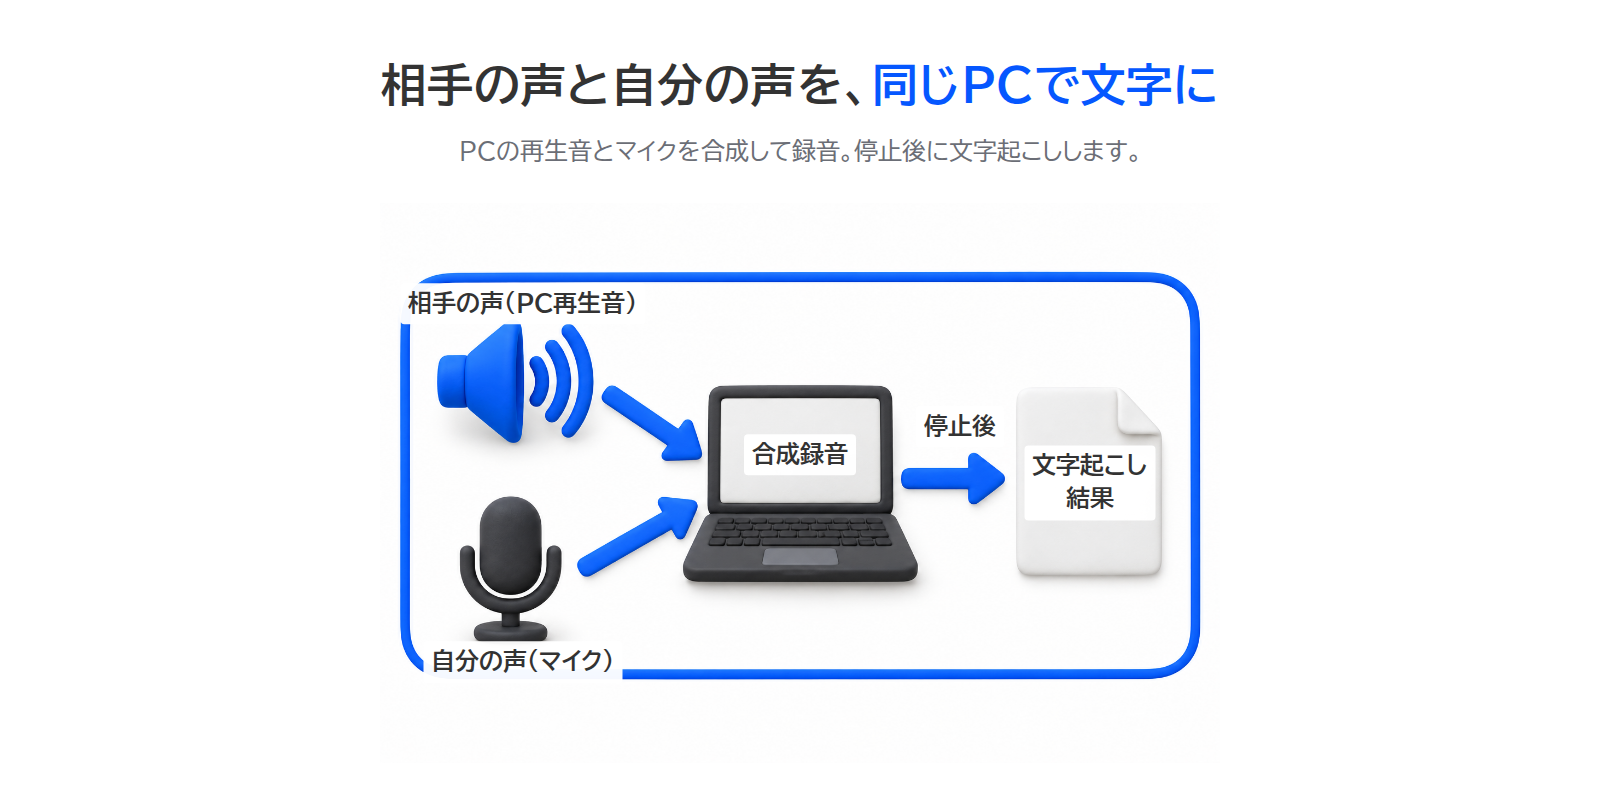
図は音声の流れを示しています。会議サービスから再生された音とマイク入力を合わせ、録音停止後に文字へ変えます。マイクと相手の声を別々の音声ファイルとして書き出す機能ではありません。
画面共有に関係する権限を使いますが、映像トラックは取得直後に停止する実装です。Local Transcriberは会議の映像を保存しません。PC音声の取得を拒否した場合や、途中で共有が終わった場合は、理由を表示してマイクだけの録音を続けます。
用語集で、会議に出る名前の表記を伝える
用語集には、社名・人名・製品名などを最大500文字まで入力できます。録音からの文字起こしにも、既存の音声・動画ファイルの文字起こしにも共通で使う欄です。長い録音でも、各処理区間で用語を参考にします。
たとえば会議でLocal TranscriberやWhisperの話をするなら、その表記を入力します。人名が複数の漢字に聞き取れる場合には、会議に参加する人の正しい名前を入れる使い方です。ただし、登録した文字列へ必ず変換する置換辞書ではありません。出力の確認は必要です。
デスクトップアプリでは、用語集のほかにマイク、表示言語、PC音声の設定も保存します。起動時に内部の接続ポートが変わっても引き継ぐ実装です。ブラウザでソースから使う場合は、そのブラウザの接続先ごとの保存になります。
話者分離で、発言者を番号で区別する
話者を分ける(試験的・時間がかかります)を選ぶと、結果に話者1、話者2といった番号を付けます。結果の全文コピーとTXT・SRT・VTT・JSONへの書き出しにも反映します。人物名を特定する機能ではなく、会議サービスの参加者名を取得して付けるものでもありません。
利用には、対応する追加ライブラリを読み込めることと、8 GiB以上のメモリが必要です。条件を満たさない環境では選択欄が表示されません。初回は約46.6MBの専用モデルを取得し、準備後はCPUでオフライン処理します。
モデル準備中に始めた文字起こしには話者ラベルが付きません。進捗表示が終わり、チェックが入った状態を確かめてから録音やファイルの処理を始めてください。話者分離はデフォルトでOFFになり、再起動やページの再読み込みでもOFFへ戻ります。
Turboを選ぶ条件と、既存モデルの扱い
新規セットアップでは、メモリ32GB以上のPCにTurbo(large-v3-turbo)を自動選択します。ダウンロードするモデルの目安は約1.62GBです。すでにMediumなどを導入している場合は、そのモデルを維持します。
| PCのメモリ | 新規セットアップ時のモデル |
|---|---|
| 8GB未満 | Tiny |
| 8GB以上16GB未満 | Base |
| 16GB以上32GB未満 | Small |
| 32GB以上 | Turbo |
32GB以上はアプリがTurboを自動選択する基準です。オンライン会議の録音機能を使うために、すべてのPCで32GBが必要なわけではありません。導入済みモデルの変更は、設定にあるより良いモデルを確認から候補を確認して選びます。
この記事では、会議1時間分を何分で処理できるか、旧モデルより何倍速いかは示していません。使うモデル、CPUやGPU、音声内容を合わせた比較を行っていないためです。初回は短いテスト録音で、終了までの待ち時間と読み直しに必要な量を確かめてください。
新しいバージョンの通知とLinuxの位置づけ
画面上部とトレイから、新しいアプリのダウンロード先を確認できるようになりました。自動でアプリを書き換える機能ではありません。モデルの切り替えと、アプリそのものの更新は別々です。
LinuxにはUbuntu 22.04以降のx86_64向けテストビルドがあります。ファイルの文字起こしとマイク録音は使えますが、LinuxのデスクトップアプリではPC音声のスイッチを表示しません。今回説明する、会議の相手の音声を直接取り込む用途ではWindows・Macとの違いがあります。
Linuxではウィンドウを閉じるとアプリが終了し、録音中や一時停止中には確認を出します。通常の配布構成では要約も非表示です。LinuxのGUI動作は資料上で未検証のため、Windows・Macと同じ操作がすべて使えるとは扱わないでください。
これらの仕様は0.7.0の日本語READMEと、機能ごとの実装資料に記載されています。
Zoom・Teams・Google Meetで使う手順
1. 会議前にモデルの準備を済ませる
製品ページのダウンロードから、自分のOSに合うファイルを取得します。Windowsでは、ZIP全体を展開してからLocalTranscriber.exeを起動してください。MacはApple Silicon向けのDMGを開き、アプリケーションフォルダへアプリを移します。今回のMac配布にIntel Mac向けのファイルは含まれません。
初回起動時は、文字起こしモデルのダウンロードが発生します。配布アプリには実行に必要なものが同梱されているため、PythonやNode.js、ffmpegを別にインストールする手順はありません。モデルの準備は会議開始前に終えておきます。
話者分離も使う場合は、専用モデルを追加で準備します。文字起こしモデルの準備完了と、話者分離の準備完了を混同しないでください。会議が始まってからモデル取得を待つことにならないよう、使う機能を前日などに一度開いておくと進めやすくなります。
2. 会議サービスとLocal Transcriberの音声を設定する
Zoom・Teams・Google Meetでは、普段どおり会議に参加して、相手の声がこのPCから聞こえる状態にします。そのうえでLocal Transcriber側のマイクを選び、PC音声のスイッチをONにします。会議サービスのクラウド録画ボタンを押すことは、このアプリの録音手順には含まれません。
| 会議の参加方法 | Local Transcriberで確認すること |
|---|---|
| Zoomのデスクトップアプリ | 相手の声をこのPCで再生し、自分が使うマイクを録音欄で選ぶ |
| Teamsのデスクトップアプリ | 会議側の音声デバイスと、録音側のマイク選択をそれぞれ確かめる |
| Google Meetをブラウザで利用 | 同じPCで相手の声を再生し、配布アプリ側でPC音声をONにする |
会議をスマートフォンで聞き、文字起こしだけPCで起動しても、そのPCに相手の音声は届きません。会議の音をどの機器で再生しているかを確認します。また、会議サービス側のミュートと、別アプリであるLocal Transcriberのマイク録音は同じ操作ではありません。会議のミュートだけで録音も止まったと考えず、Local Transcriberの状態を確認してください。
ここまでの手順は、配布アプリを使う場合です。Local Transcriber自体もブラウザで動かす場合には、録音開始時の共有画面で、会議のタブや画面と音声共有を選びます。タブ共有で取得できるのはそのタブの音声だけです。別アプリで開いた会議の音声まで入るとは限りません。
ブラウザにPC音声のスイッチが表示されても、OS・ブラウザ・共有元の組み合わせによって音声を取得できない場合があります。ブラウザの共有機能が使えることと、会議の音を実際に録れることは分けて確認します。
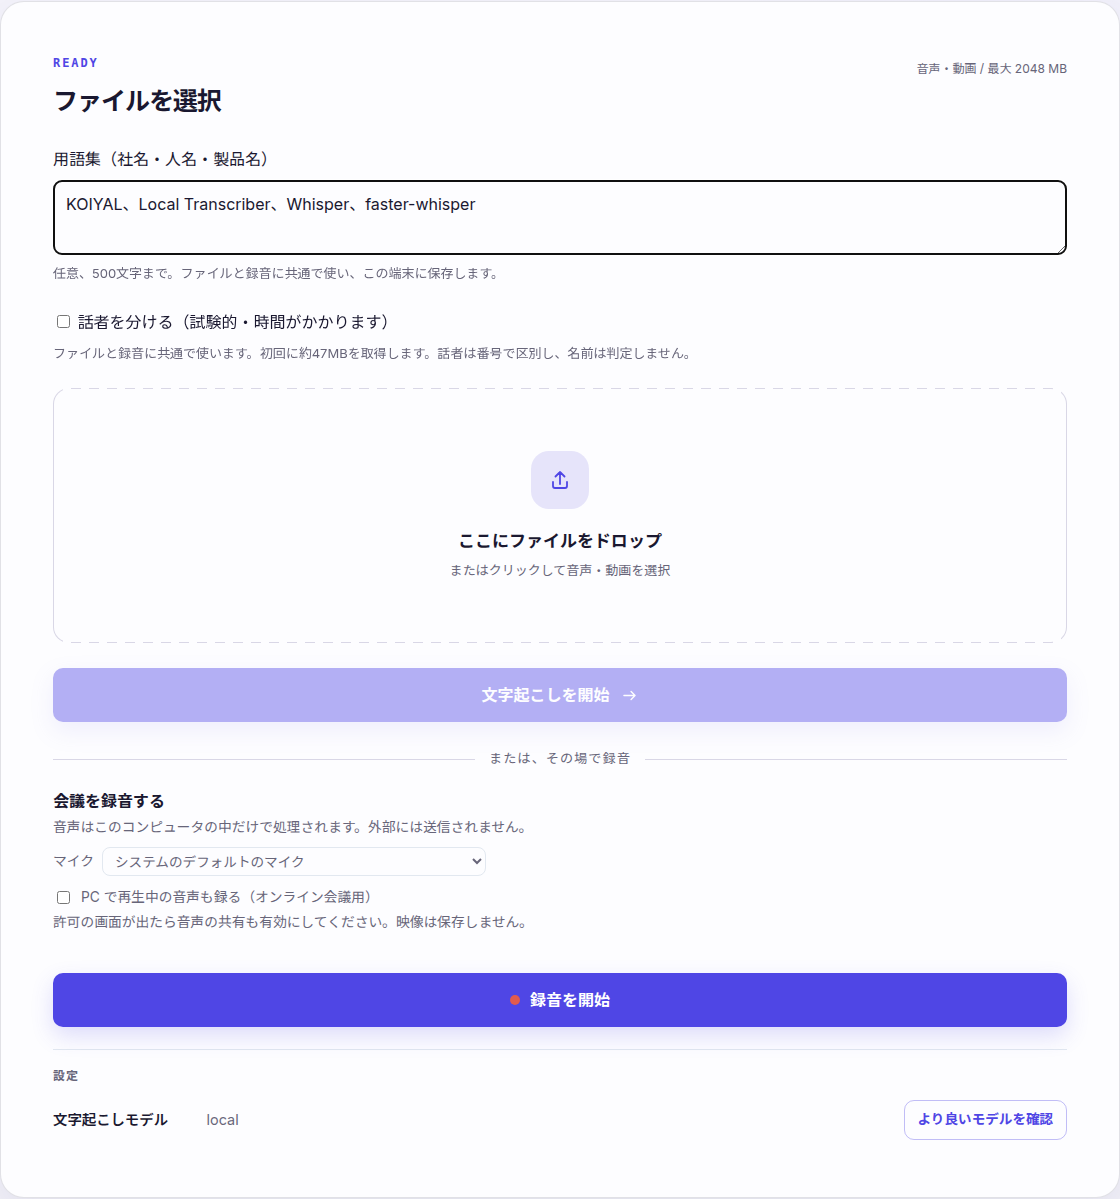
ソースから起動したブラウザの設定画面です。用語集には説明用の製品名を入力しています。録音やOSの権限ダイアログを実際に検証した画面ではありません。
3. 相手だけ、自分だけの短い録音で確かめる
録音を開始したら、PC 音声ありの表示とレベルメーターを確認します。最初のテストでは、相手だけが話す時間と、自分だけが話す時間を作ってください。その後で録音を止め、両方の発言が文字起こしされるかを確かめます。
PC 音声ありは、音声トラックを取得したことを示す表示です。相手の声が無音ではないことまでは保証しません。資料ではMacの権限不足などにより、取得したトラックが無音になる場合も挙げています。自分のマイクだけでメーターが動いている可能性があるため、自分が黙った状態で相手の声を確認する手順が必要です。
このテストの合格条件は、二人の声が入ること、二重に聞こえないこと、会議に出る固有名詞を結果で確認できることです。記事で提案する確認手順であり、特定の会議サービスやPCでの録音成功を保証するものではありません。
4. 録音停止後に結果を確認し、必要な形式で保存する
会議が終わったらLocal Transcriberで録音を停止します。停止をきっかけに文字起こしが始まり、話者分離を有効にしている場合はその処理も続きます。リアルタイム字幕のように、話している途中から文章を追う用途には向きません。
結果を読むときは、人名・会社名・金額・日付・担当者・期限を優先して確かめます。話者ラベルが付いていても、その人の発言と判断して共有する前に内容を確認してください。特に担当の割り当てや承認の発言は、単語が合っていても話者が違えば意味が変わります。
文章として使うならTXT、字幕として使うならSRTやVTT、区間情報を別の処理に渡すならJSONを選べます。コピーした結果は、決定事項・未決事項・次の行動に分けて議事録へまとめる材料になります。
文字起こしの出力と、その内容を確認した議事録は分けて保存すると、後から読み直しやすくなります。
要約は対応環境に表示される任意の機能です。今回の録音手順に要約の利用は必須ではありません。文字起こしを確認する前に要約だけを共有すると、固有名詞や話者の誤りも見逃しやすいため、先に元の文章を確認します。
WindowsとMacで異なる準備
Windowsは10/11のx64向けアプリで利用する
WindowsのPC音声録音は、Windows 10/11のデスクトップアプリ向けに実装されています。ZIPの中の実行ファイルだけを別の場所へ移さず、展開したフォルダ全体を保って起動してください。録音にはマイクの使用許可も必要で、PC音声だけの録音には対応していません。
録音できない場合は、選んだマイクとOS側のマイク許可を確かめます。相手の音だけ入らない場合は、PC音声がONか、会議音が同じPCで再生されているかを確認してください。自分の声も相手の声も入らない状況を、用語集やモデルの変更で直そうとしないことが切り分けの助けになります。
Macは未署名アプリの起動許可と、録音権限を分ける
Mac向け配布アプリは未署名で、Appleの公証も付いていません。公式のGitHub Releasesから取得したファイルであることを確認し、会社の管理PCではアプリの利用ルールにも従ってください。起動を許可する判断と、録音する内容の扱いは別に必要です。
- DMGを開き、Local Transcriberをアプリケーションフォルダへ移します。
- 一度アプリを開き、開発元を確認できないなどの警告が出ることを確認します。
- システム設定のプライバシーとセキュリティを開き、当該アプリのこのまま開くが表示されていれば選びます。
- 確認画面で開く意思を示し、アプリを起動します。
この方法は、信頼できる配布元から入手したアプリに例外を設定する手順です。管理されているMacでは設定が使えない場合もあります。警告の内容が異なる場合やボタンが見つからない場合は、一律に保護機能を解除せず、Appleのアプリ起動に関する案内と配布元の説明を確認してください。
起動できた後も、PC音声の録音には別の権限が必要です。マイク、画面収録、システム音声の収録を許可します。設定を変更した後はアプリの再起動が必要な場合があります。画面収録の権限を求めても、Local Transcriberが保存するのは音声で、会議映像ではありません。
MacでPC音声を録る条件は、macOS 14.2以降のパッケージアプリです。古いmacOSや開発用の起動方法ではPC音声のスイッチを隠します。配布アプリの対応条件と、ソースから起動したブラウザの画面を同一視しないでください。
認識精度を上げるために、録音前に整えること
用語集は今回の会議の表記に絞る
用語集には、正しい表記で出したい単語を短く並べます。アプリの紹介会議なら、次のような入力です。
KOIYAL、Local Transcriber、Whisper、faster-whisper
参加者の人名や案件名を追加する場合も、その会議で実際に出るものに絞ります。文章で議事録の書き方を指示したり、過去の会議の名前を大量に残したりする欄ではありません。たとえば、決定事項を箇条書きにするよう求めても、用語集の役割とは合いません。
入力上限の500文字は、登録したすべての語が常に同じ強さで使われる保証ではありません。内部のプロンプトにはトークン数の制限もあるため、誤りやすい名前を優先し、短く書きます。トークンはモデルが文章を扱う単位で、日本語の文字数とは一致しません。
同じ会議の前後で表記が変わると、用語集の内容も古くなります。製品名の変更があれば直し、不要な名前は消してください。保存される欄なので、前回入力した内容がそのまま残っていることも確認します。
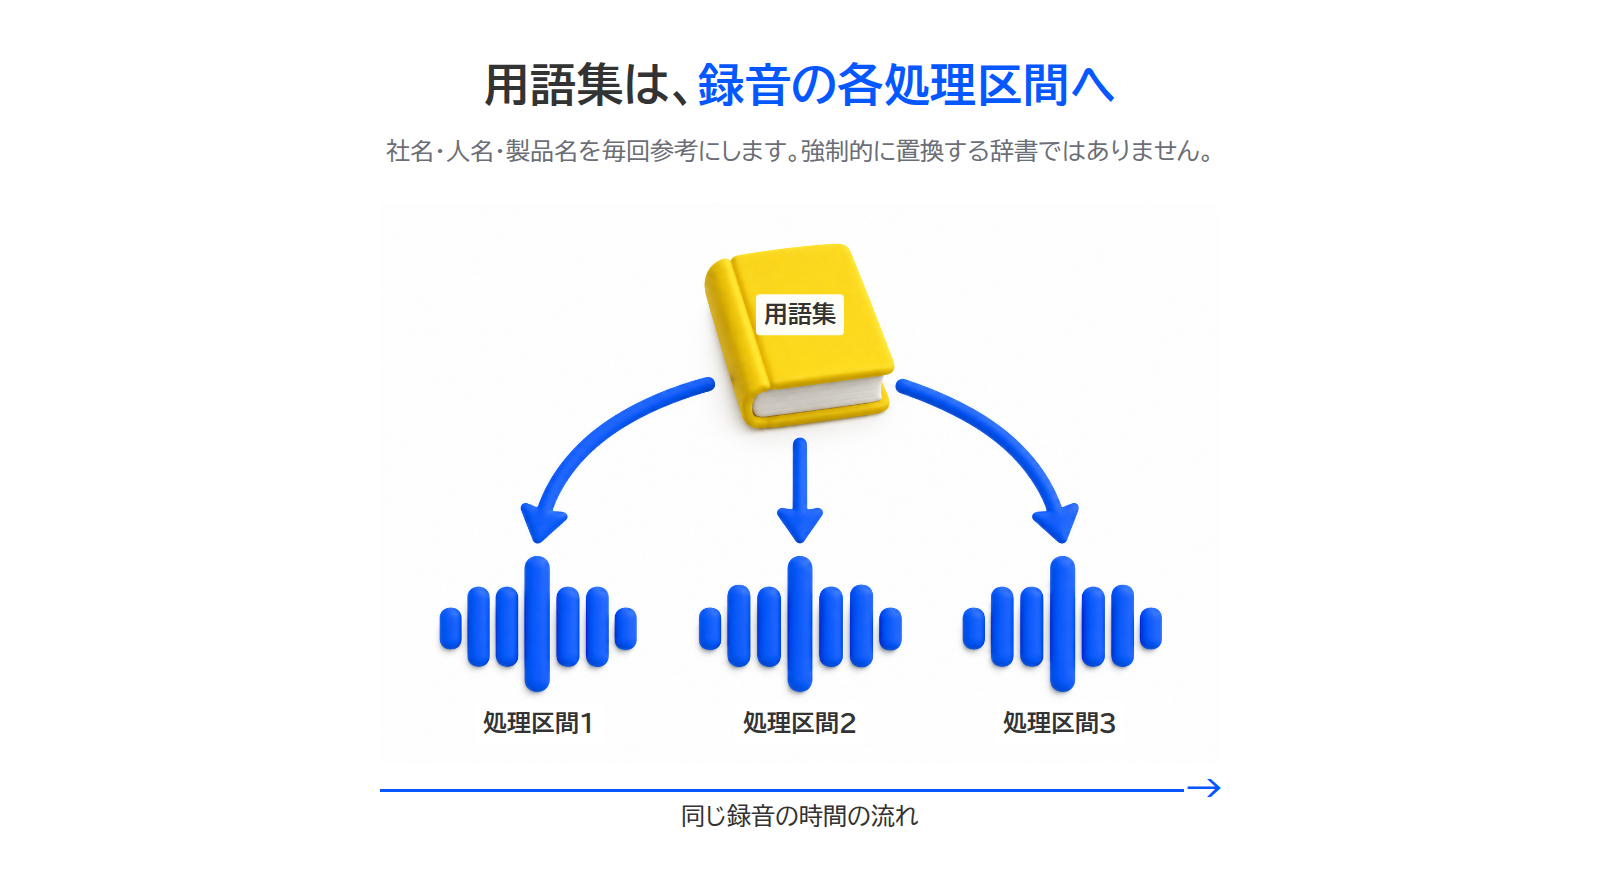
図は、用語を最初の一度だけでなく各処理区間へ渡す関係を表しています。矢印はヒントを渡すことを示し、登録語へ強制変換する意味ではありません。
ヘッドホンで相手の音声の二重取り込みを避ける
PC音声を直接録るときにスピーカーを使うと、その音をマイクも拾うことがあります。相手の声がPC音声とマイクの両方へ入り、二重になる原因です。最初はヘッドホンを使い、自分の声はマイクから、相手の声はPC音声から入る構成で試してください。
Bluetoothヘッドセットでは、マイクの使用によって音質や入出力デバイスが変わる場合があります。音が取れない場合は、有線ヘッドホンと内蔵マイク、またはUSBマイクで確かめる方法が資料に示されています。機器を一度に全部変えず、録音できた組み合わせを残してください。次の会議でも確認しやすくなります。
通知音や音楽も、PC全体の再生音として録音に入ります。会議の前には不要な再生を止め、通知設定を確認してください。相手の発言と重なった通知音を、用語集だけで取り除けるとは考えないほうが適切です。
無音警告は、録音の確認を補うもの
録音中に小さい音の状態が30秒続くと、マイクと入力デバイスを確認する警告を出します。マイクが外れている、違う入力を選んでいるといった状況に気づくための機能です。実装では入力レベルを基準にしており、発言の内容を判定しているわけではありません。
0.7.0でPC音声を合成した場合、メーターは合成後の音を見ます。したがって、自分の声が入っていれば、相手の声が無音でも警告が出ない可能性があります。警告が出ていないことだけを録音成功の根拠にせず、会議前の二人分のテストと組み合わせて使ってください。
文字起こし側には無音区間を除く処理もあります。こちらは音声認識の前処理であり、録音中の警告とは別の役割です。発言が抜けている場合は、モデルの選択だけでなく、そもそも必要な音が録音へ入ったかを先に確認してください。
制約を踏まえて議事録へ仕上げる
話者分離は、短い交代や同時発話で誤ることがある
話者分離では、声の区間と文字起こしの区間の重なりを使って、各区間へ番号を割り当てます。一つの文字起こし区間を細かく分割し直す方式ではないため、短い相づち、すぐ次の人へ移る発言、重なった声を正しく区別できない場合があります。似た声や雑音も、誤りの要因です。
話者番号は録音ごとの登場順です。別の日の会議でも話者1が同じ人になるとは限りません。出席者の一覧と照らして、番号を人名へ直す必要がある場合は人が確認します。発言内容から人を推測しただけの状態で、確定した担当者名として扱わないようにします。
話者分離には通常の文字起こしに加えて時間とメモリが必要です。失敗した場合は、話者ラベルなしの文字起こし結果と元音声を残す設計です。分離をONにすれば議事録が完成する、と考えるのではなく、確認する箇所を探す補助として利用してください。
録音の同意とファイルの保存先を決める
ボットが参加しないことは、会議の相手に録音を知らせなくてよい理由にはなりません。録音前に目的を伝え、相手の同意を得てください。会議後に誰へ共有するか、音声と文字をいつまで残すかも、利用ルールに合わせて決めます。
アプリのデフォルトでは、文字起こしが成功すると一時保存した元音声を削除します。文字起こしや話者分離に失敗した場合、処理途中で終了した場合などは元音声を残します。録音を長期保存するアーカイブとしては扱わないでください。元音声を後から聞き直す必要がある運用では、READMEの保持設定を含めて保存方法を先に確認します。
結果ファイルは端末に残りますが、アプリを再起動すると画面から過去の結果を参照できません。結果が表示されている間に必要な形式で書き出し、仕事で使う保存先へ置いてください。共有フォルダやクラウド同期フォルダを選んだ場合には、その保存先側の共有設定も確認します。
初回の準備と新版確認では通信がある
音声・用語集・文字起こし・要約を外部へ送らない設計でも、アプリのすべての動作が無通信になるわけではありません。文字起こしモデルの初回取得、必要に応じた話者分離や要約モデルの準備、利用者が選んだモデル更新ではダウンロードが発生します。
アプリの新版確認は、GitHub APIへ1回問い合わせ、その結果を失敗時も含めて24時間保存します。インストール後の一生涯で1回だけ、という意味ではありません。キャッシュが有効な間は同じ結果を使い、期限が切れた後の確認では再び問い合わせる仕組みです。リクエストには音声や文字起こし本文を含めません。
通信を停止するには、起動するアプリに環境変数 LT_UPDATE_CHECK=off を渡します。0・false・noも停止値として扱います。アプリ画面に通信停止のスイッチがあるわけではないため、会社の管理PCでは起動方法を含めて情報システム担当者へ確認してください。
必要なモデルを準備した後の文字起こしはオフラインで実行できます。外部との通信を許さない環境で使うなら、モデルの準備を済ませる段階と、会議を処理する段階を分け、新版確認の設定も確認しておきます。
仕組みを知ると、長い録音の注意点が分かる
Whisperの30秒窓と、繰り返しを抑える設定
Local Transcriberは、Whisperを動かすライブラリであるfaster-whisperを使って文字起こしします。Whisperは長い音声を一度に一文へ変えるのではなく、30秒の窓を動かしながら処理する仕組みです。この30秒は音声認識の処理単位であり、録音できる長さの上限ではありません。Whisper公式READMEに処理方法が説明されています。
前の区間で出力した文章を、次の区間の参考にする設定が condition_on_previous_text です。文脈を引き継ぐ一方で、同じ文の繰り返しなど、誤った出力を引きずる原因にもなります。0.7.0の実装では、この値を False にして繰り返しを抑える方針にしています。
無効にすると、区間をまたいだ文章の一貫性が下がる可能性もあります。faster-whisper側の説明にも両面が記載されており、すべての音声で精度が向上する設定ではありません。本文中に同じ表現が続く場合や、区間ごとに名前の表記が変わる場合には、結果を読み直す必要があります。faster-whisperの実装と引数の説明を参照してください。
hotwordsで用語を各区間へ渡す
前の文章を引き継がない設定でも、毎回同じ固有名詞を参考にできるように、用語集は hotwords として渡します。最初の区間だけに渡す initial_prompt と併用すると、最初の用語が重複するため、0.7.0の呼び出しではその併用をしていません。
この構成は、長い会議の後半にも社名や製品名のヒントを渡すためのものです。音が聞き取れない区間を復元したり、書かれた名前の人物を声から特定したりする機能ではありません。用語集は表記のヒント、話者分離は声の区別、録音設定は音を取り込む準備として、それぞれ役割が異なります。
設定名を覚えて使う必要はありません。利用者が行うのは、今回使う名前を短く登録し、二人の音声が入ることを確かめ、出力を見直すことです。実装は0.7.0の文字起こし処理で確認できます。
まず短い会議で、録音から保存まで確認する
KOIYALでは、オンライン会議の文字起こしを導入する最初の確認を、認識モデルの大きさだけで決めないことを勧めます。自分と相手の声が入り、必要な名前を読める形にでき、確認済みのファイルを仕事の保存先へ残せること。この一連の操作を確かめるほうが、日々の議事録に使う判断につながります。
最初は録音の同意を得た短いテストで、用語集を入力してPC音声をONにします。相手だけ・自分だけの発言を録音し、停止後の文字起こしからTXT保存まで試してください。話者分離はその後で追加すると、音声の取得と話者番号の誤りを分けて確認できます。
Local Transcriberは無料で配布しており、文字起こし用のAPIキーや会員登録は不要です。製品ページからダウンロードできます。変更点の一覧は0.7.0の公開案内、配布ファイルと更新内容はGitHubの0.7.0リリースをご確認ください。
確認した資料
確認日: 2026年10月23日。製品の説明は0.7.0の仕様に固定しています。
- 日本語README(確認したコミット): 配布形式、用語集、モデル選択、通信、保存の扱い。
- オンライン会議録音の実装・確認項目: OSごとの条件、音声合成、未検証の実機操作。
- 話者分離の実装・確認項目: 必要メモリ、番号の付け方、制約。
- 文字起こし処理、新版確認、録音の管理: 引数、通信のキャッシュ、無音警告。